明察秋毫,是视觉检测这行最基本的要求:只占画面千分之二的划伤、几十像素外的安全帽、包装上一排小点打出来的日期,都得看清楚。
秋毫视觉是我一个人的工作室,专接相机和算法能解决的具体问题。下面是最近做的四个演示,每个都写了怎么做的、实际测出来多少,以及还不够好的地方。
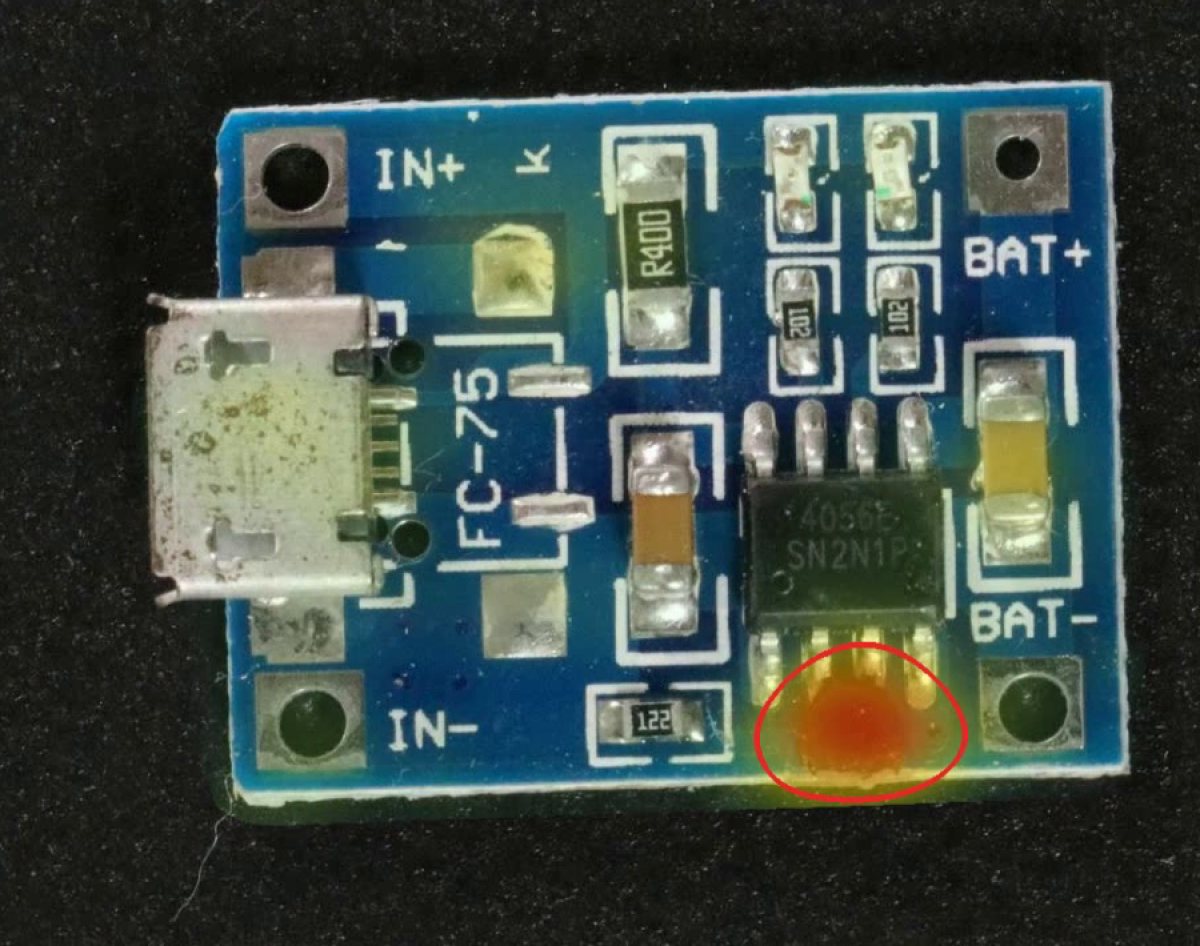 模型只看过好的电路板。芯片下面那处划伤,它没见过,所以标了出来。
只看过良品的缺陷检测
2026 年 10 月 · 工厂外观质检 · PCB 电路板
做缺陷检测,最常听到的难处是坏样本太少。产线一天出不了几个坏件,想攒几百张去训练检测模型,要等好几个月;等攒够了,又冒出一种没见过的新缺陷。
所以这里换了个思路:只给模型看良品。它记住两百张好电路板上每一小块长什么样,测试时哪一块和记忆里都对不上,哪一块就是缺陷,热力图直接画出来。训练一次三分钟。
在公开数据集 VisA 的 PCB 上,AUROC 0.996。没参与调阈值的那一半测试图里,51 块好板零误报,50 块坏板抓到 47 块。第一版其实有误报——板子旁边背景上的一粒灰被当成了缺陷,后来加了"只看板子本身"的区域限制才解决。
还不够好的地方:只占画面千分之二的小缺陷,比如少了一颗小电阻,会漏。要靠提高分辨率,或者把板子分块放大再看。
模拟产线,20 块板依次经过。判定都是模型的真实输出,其中第 17 块是漏掉的那块。数据:VisA (Amazon),CC BY 4.0。
拖一下阈值试试
异常分数超过阈值就判 NG。阈值往左拖,坏板漏得少,但好板也开始被误报;往右拖正好相反。下面统计的是没参与调阈值的那 101 块板,图里的阈值线就是你拖到的位置。
–块坏板漏检(共 –)
–块好板误报(共 –)
示例图 24 张(12 坏 12 好),右下角写的是真实情况;黄色"判错"表示在当前阈值下判错了。
远处的工人也要看清
2026 年 10 月 · 工地安全帽 · 实拍视频
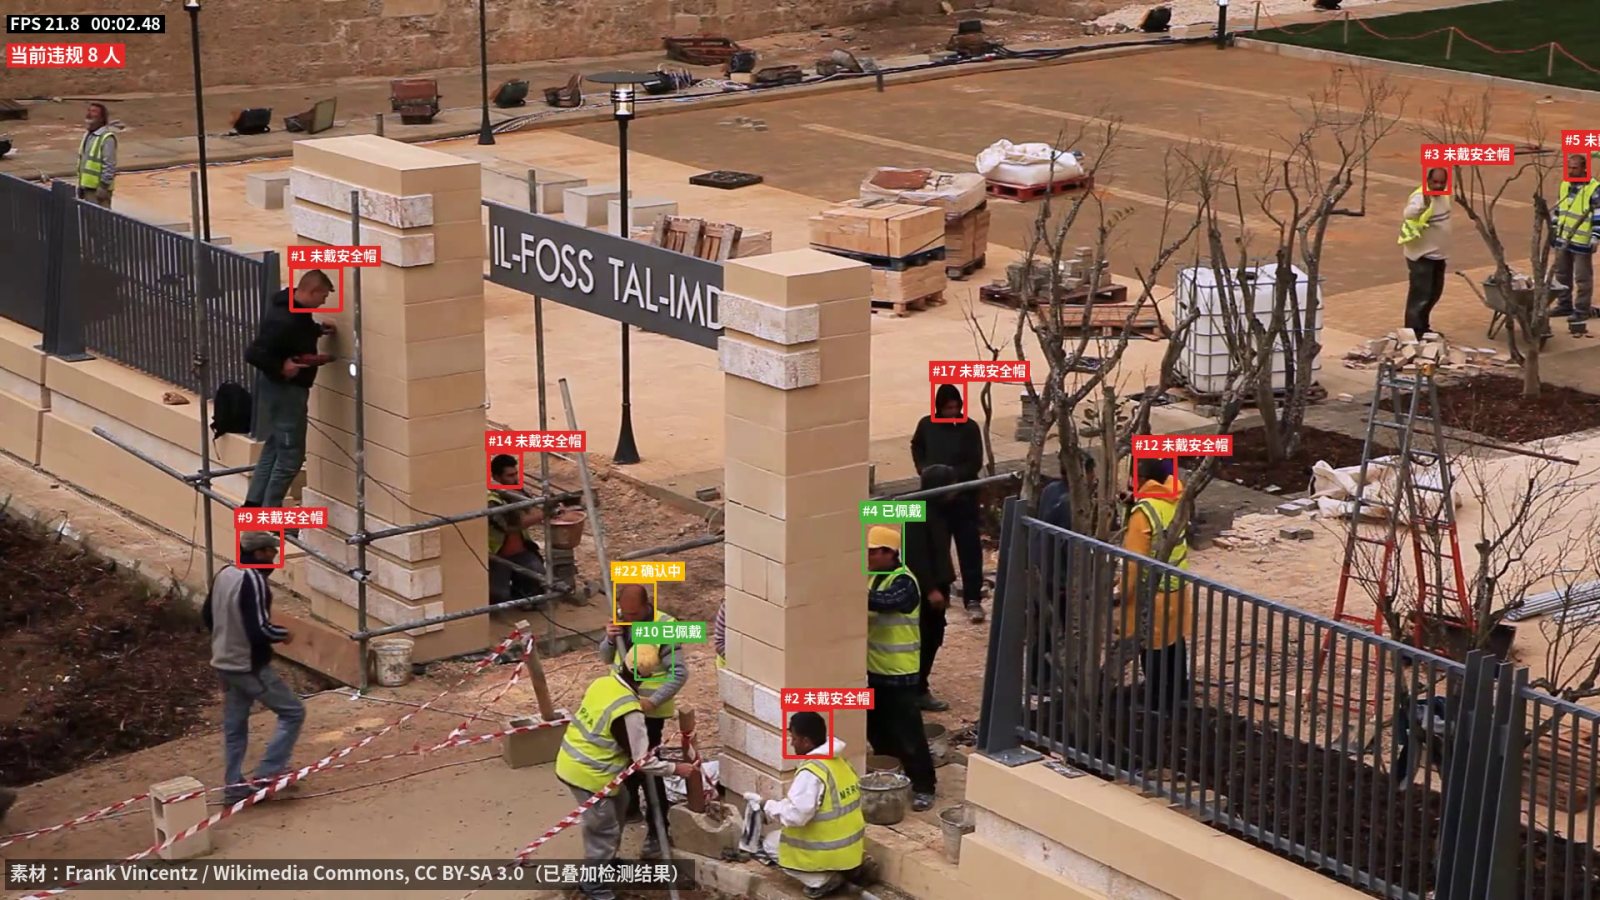 同一帧里标出 8 个没戴安全帽的人。素材:Frank Vincentz / Wikimedia Commons,CC BY-SA 3.0,已叠加检测结果。
工地摄像头一般装得高、拍得远,人头只有二三十个像素。直接拿检测模型在整幅画面里找人头,四个人里有三个找不到。
改成两步:先找人——人比头大得多,好找;再把每个人的上半身裁出来放大,判断戴没戴安全帽。能找到头的人从 27% 涨到 71%。毛线帽、兜帽也会被判成没戴,这恰好是工地上最常见的糊弄。
告警这部分花的心思不比模型少:连续十几帧都确认没戴才报警;一个人被柱子挡了一下、换了编号,也不会重复报;每次报警自动存一张截图。22 秒的视频里报了 12 次,我逐张看过,都是真的。
还不够好的地方:背对镜头的人看不到头,弯腰的姿势偶尔会判错。
完整的 22 秒。右侧是告警记录,每条都带截图。
喷码不只要认出来
2026 年 10 月 · 食品药品包装 · 生产日期
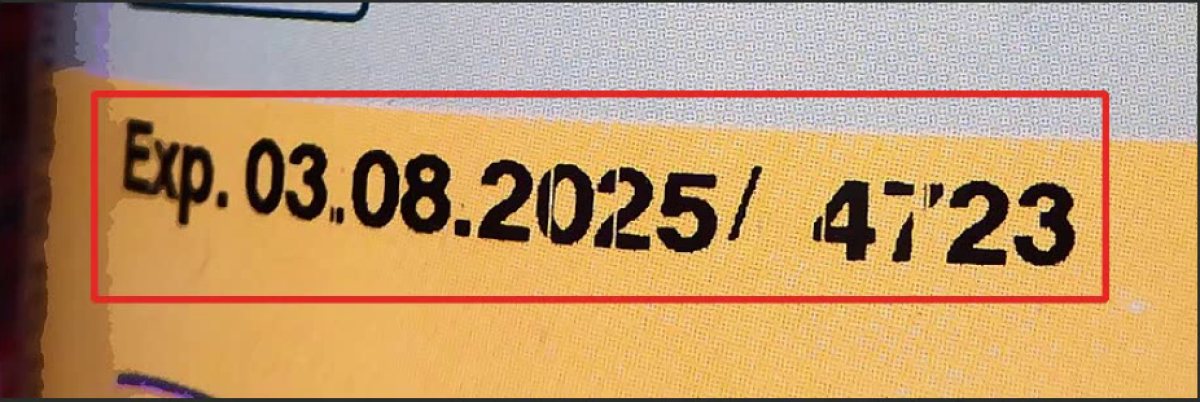 读出来是 2025.08.03,但这一批应该喷 08.04——日期错误。图片:Wikimedia Commons,开放许可。
食品、药品包装上的日期,喷漏了、喷花了、换班后忘了改日期,都是要召回的事故。所以这个程序不只读出日期,还拿它和"今天应该喷的日期"对一遍,结果分四种:合格、漏印、模糊待复核、日期错误。
喷码机打的很多是点阵字,一个个小点,通用文字识别读起来经常缺字;字间距一大,一个日期还会被拆成好几段。先把点连成笔画,再把同一行的碎片拼回去,在 665 张真实商品照片上读对了 88.7%。这还是没专门训练过的结果,拿到现场样本微调,还能往上走。
"有没有喷"不靠文字识别来判断,而是直接看喷码框里有没有墨。喷花了的字一个也认不出,但墨还在——这是待复核,不是漏印,两种问题在产线上的处理方式完全不同。
读不准的时候,它会判成异常交给人看,而不是把错的日期放过去。
15 件实拍包装:6 件故意做成漏印、模糊、日期错误,全部判对;9 件原样的里 6 件合格,1 件本来就印得糊、判为待复核,2 件(稀疏点阵、斜着印的)读错了,判成日期错误。
在线试一下
选一张示例,或者上传你自己的包装照片,在图上拖一个框把日期框住,点"开始识别"。可以填上应该喷的日期,看它会判成什么;不填就只看有没有喷、清不清楚。
在图上拖一个框选中日期;不框就识别整张图(慢一些)。
第一次点识别时会下载识别模型,约 33 MB,之后浏览器会缓存。图片只在你自己的浏览器里处理,不会上传到任何服务器。示例图片来自 Wikimedia Commons,署名见页脚。
大模型读单据,对一遍账再放行
2026 年 10 月 · 单据录入 · 本地多模态大模型
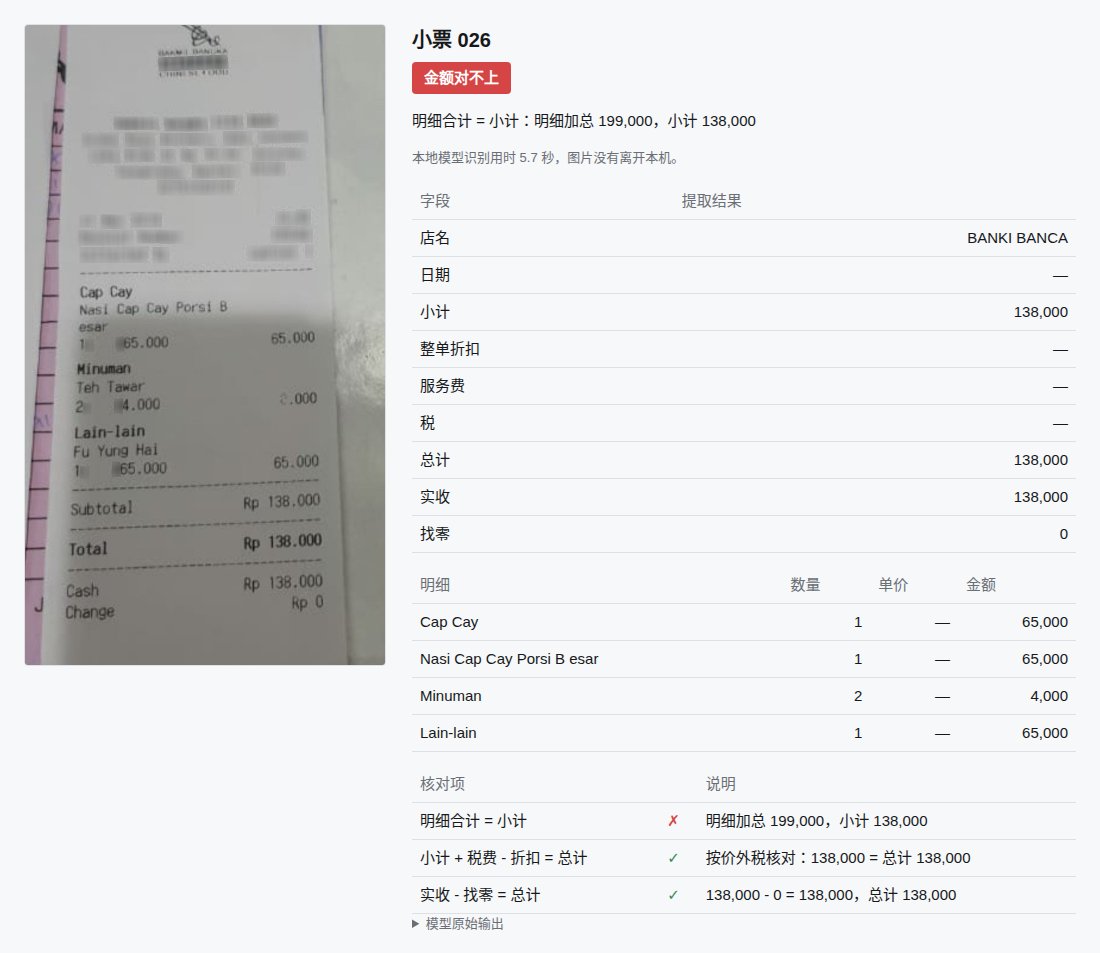 模型把小票上的分类标题"Cap Cay"当成了一道菜,明细加起来 199,000,小计却是 138,000——算术一查就露馅,交给人看。数据:CORD (Clova AI),CC BY 4.0。
多模态大模型现在拍一张小票就能把店名、明细、金额都读出来,用起来很顺手。麻烦在于它读错的时候语气和读对的时候一模一样,你没法只靠它自己判断哪张能信。
好在单据上的数字本身有冗余:明细加起来该等于小计,小计加税该等于总计,实收减找零也该等于总计。所以我在模型后面加了一层算术核对,每个等式都对得上的直接通过,对不上的交人工。模型用的是 20 亿参数的 Qwen3-VL,在本机显卡上跑,一张四五秒,图片不出机器。
在公开数据集 CORD 的 100 张小票上:规则判通过的 60 张,我对着原图逐张看过,金额真正读错的只有 1 张;模型读错的单据里,八成多被规则拦了下来。也就是说,人工从"每张都看"变成"只看被拦下的那四成"。
还不够好的地方:拦不住"自洽的错"。有一张把抹零前的 334,011 当成了总计,可它刚好等于小计加税,所有等式都对得上。税和服务费也读得最差,对的只有六成和四成左右——好在读错了大多会被拦下。
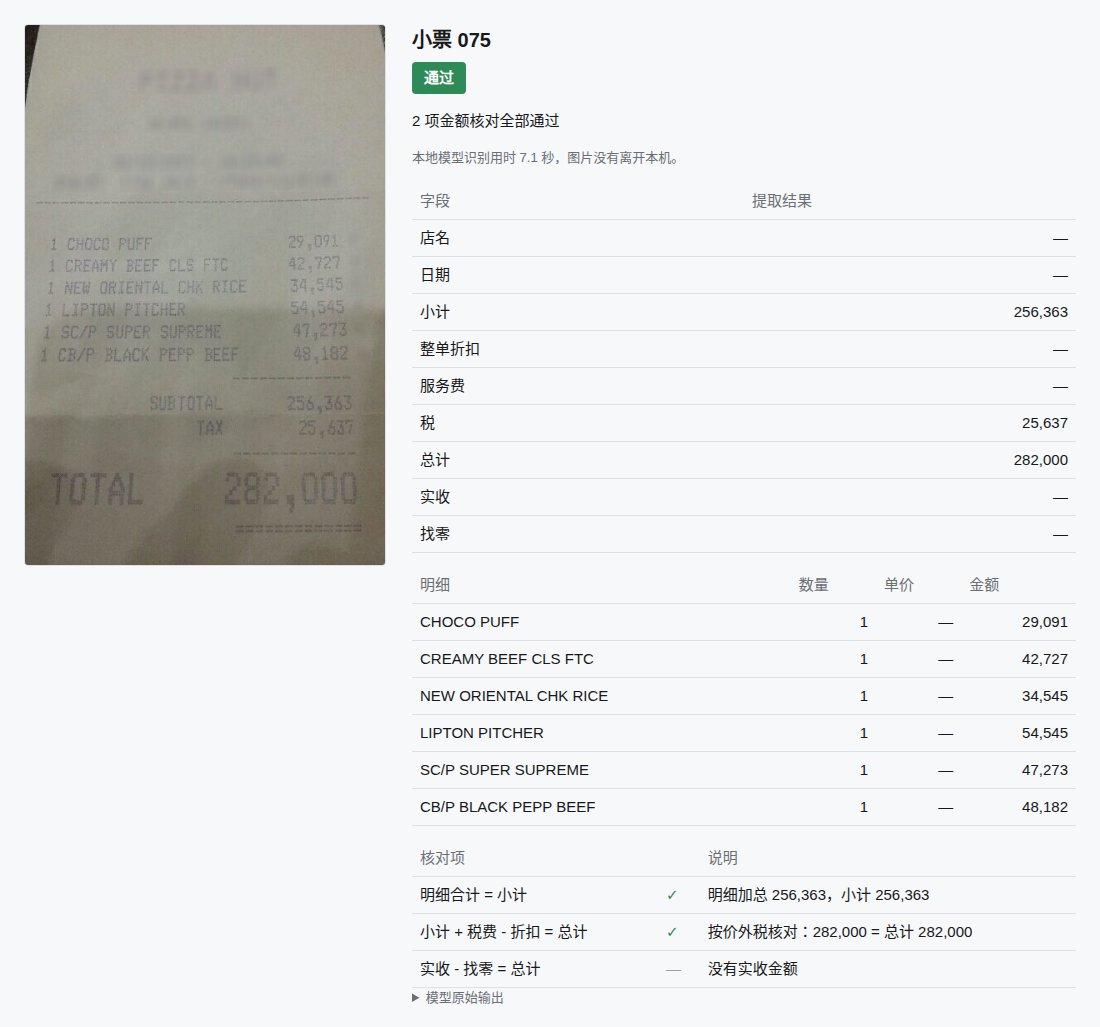 这张三项核对全部通过,直接入账。报告里每一项怎么核的都写着,客户拿到可以自己复查。
常见场景怎么做
下面是我接触过的场景的一般做法。周期指首版能看到效果,真正上线还要看验收标准定得多严。
| 场景 | 一般怎么做 | 需要你准备 | 首版 |
|---|
| 外观缺陷 | 划痕、脏污、缺件。坏样本少就只用良品建模;有一些坏样本时可以再加一个检测模型兜底。 | 良品一两百张,坏件有几十张更好;相机和光源位置固定 | 1–2 周 |
| 有没有、装没装对 | 目标检测加规则判断:该有的件在不在、位置对不对。 | 每种状态各几十张 | 约 1 周 |
| 计数 | 零件、药片、人流。检测或分割,视频里再加跟踪去重。 | 一段有代表性的视频或几十张图 | 1–2 周 |
| 尺寸测量 | 多数用传统视觉:标定相机、找亚像素边缘,比深度学习更稳也更好解释。 | 标定板、固定工位、公差要求 | 1–2 周 |
| 字符和读数 | 喷码、铭牌、仪表。文字识别加业务校验,见上面的喷码演示。 | 几十张现场照片、判对错的规则 | 1–2 周 |
| 安全行为 | 安全帽、反光衣、区域闯入。先找人再判断,多帧确认后告警、截图存证。 | 现场摄像头的视频(能给视频流最好) | 1–2 周 |
| 单据和票据 | 小票、发票、送货单、报销单。本地多模态大模型提取,再用算术和业务规则核对,对不上的交人工。 | 几十张真实单据、要提取哪些字段、核对规则 | 1–2 周 |
| 加速和部署 | 已有模型转 ONNX / TensorRT、量化,搬到工控机或边缘盒子上跑。 | 模型文件、目标硬件 | 3–7 天 |
做这些演示时的笔记
只用良品做缺陷检测
对应第一个演示 · PatchCore
思路很朴素:把两百张好板子切成很多小块,用一个在 ImageNet 上预训练好的网络把每一小块变成一串数字,存起来当"正常长什么样"的记忆。检测时,新板子的每一小块去记忆里找最像的那一块,差得越远越可疑。整张图里最可疑的那一块的分数,就是这块板的异常分数。
为什么两百张就够:它不需要学"缺陷长什么样",只需要见过足够多种"正常"。同一条产线上的良品本来就很像,两百张已经覆盖得差不多了。
阈值是最容易做假的地方。我把测试图对半分:一半用来挑阈值,另一半才用来报漏检和误报。如果在同一批图上既调阈值又报数字,数字会好看得多,但到了现场就不灵了。上面那个滑块用的就是没参与调阈值的那一半。
第一版有一个误报,是板子旁边黑色背景上的一粒灰。模型没错——它确实没见过那粒灰。解决办法不是改模型,而是告诉它"只看板子本身"。这类问题在现场很常见,靠的是先把误报一张张看过去。
远处的人头为什么看不见
对应第二个演示 · 两阶段检测、告警去重
先算一笔像素账:1080p 的监控画面里,十几米外的人头大概 30 个像素高。检测模型通常把整张图缩到 640 宽再看,缩完只剩十几个像素,安全帽和毛线帽在这个尺寸下几乎没有区别。换更大的模型、更多的数据,都绕不开这笔账。
所以改成两步:先找人。人比头大得多,缩了也找得到;再把每个人的上半身单独裁出来、放大,给第二个模型看清楚。等于只在"有人的地方"用高分辨率。
告警比检测更容易出问题。单帧结果会抖,直接报警会刷屏,所以要连续十几帧都确认才报。另一个坑是跟踪器:一个人被柱子挡一下,再出来就换了编号,只按编号冷却会重复报警。我的做法是冷却期内同时记位置,新报警离旧报警很近,就当是同一个人。
喷码识别的三个坑
对应第三个演示 · 点阵字、碎片、墨迹
第一个坑是点阵字。小字符喷码机打出来的字是一个个分开的点,通用文字识别会漏字。把点"涨粗"连成笔画再识别会好很多,但涨多少要跟着笔画粗细走——一开始我按图片大小算,高分辨率照片直接被糊成一团。现在试三档,取最可信的。
第二个坑是碎片。字间距一大,"2021.10.31"会被拆成三段,单看哪段都不是日期。按行把碎片从左到右拼回去就好了,在前 30 张图上,这一条加上"裁剪时四周留白",就把准确率从 60% 拉到了 83%。
第三个坑是"没喷"和"喷花了"分不清。喷花了的字,文字识别一个也认不出,按识别结果判就成了漏印。但这两件事在产线上处理方式完全不同:没喷是喷头没出墨,喷花了是喷头脏了。现在直接看框里有没有墨,有墨认不出才算"模糊待复核"。
还有一个意外:为了让网页能加载,我把识别模型的字表从一万八千多个字裁到 135 个,结果在 665 张图上反而从 86.6% 涨到了 88.7%。字表小了,糊掉的数字就不会被认成长得像的汉字。
关于我
做了八年计算机视觉,数字图像处理方向硕士,毕业于 211 院校。这些年做的事情,大多落在"从模型到能用"这一段:样本怎么采、阈值怎么定、误报怎么压下去、在一台小盒子上怎么跑得动。
比起刷新哪个榜单上的分数,我更在意一个算法放到你的产线、你的摄像头底下,能不能一天天稳定地用下去。所以我习惯先看样本再说能不能做;做不了的,或者根本不需要算法、调一下光源就能解决的,会直接告诉你。
交付的时候你会拿到什么
能直接跑的代码和模型
以缺陷检测为例,交付包大致是这样:
交付包/
├── model/      训练好的模型和阈值
├── sdk/        Python / C++ 调用接口
├── tools/      阈值标定、批量测试脚本
├── report.pdf  测试报告
└── README.md   安装、调用、部署说明
# 调用方式(示意)
inspector = Inspector("model/pcb.pt")
result = inspector.check(image)
result.ok       # 合格 / 不合格
result.score    # 异常分数,1.0 是阈值
result.heatmap  # 缺陷位置,可以直接叠在图上
一份看得懂的测试报告
用你的样本测,每张图的判定都列出来,漏检和误报单独附图。下面是上面那个 PCB 演示的结果摘要:
| 测试图 | 数量 | 判对 | 判错 |
|---|
| 坏板 | 50 | 47 | 3(漏检) |
| 好板 | 51 | 51 | 0(误报) |
阈值用另一半图调好以后才测这一半,所以数字没有被"调"过。
可以找我做什么
- 外观缺陷检测8,000 元起划痕、脏污、缺件、错件。坏样本少也能做。
- 安全帽和安全行为识别6,000 元起接现有摄像头,告警带截图,可以推到企业微信或钉钉。
- 喷码、铭牌、仪表读数识别5,000 元起不只读出来,还按你的规则判对错。
- 已有模型的加速和部署3,000 元起TensorRT、量化,搬到 Jetson、RK3588 这类小盒子上跑。
- 单据和票据智能录入5,000 元起小票、发票、送货单。本地部署,数据不出你的电脑;自动核对,只把对不上的交给人看。
- 看样本、出方案第一次免费之后按 500 元一小时算。
交付的代码不用 AGPL 这类会"传染"的开源组件,可以放心闭源用。价格是起步价,看过样本再定。
一般怎么合作
你发十几张样本图或者一段视频,说清楚要找什么。我一到三天内回复:能不能做,打算怎么做,大概多少钱。
定下来以后按阶段付款,通常是三成预付、首版四成、验收三成。验收标准开工前就写清楚,比如漏检率、误报率各不超过多少,每一步你都先看到结果再付款。
常见问题
- 我的样本数据会外泄吗?
- 可以先签保密协议。样本只用在你这个项目上,结束后按你的要求删除;没有你的同意,不会出现在我的任何案例里。
- 需要到现场吗?
- 多数项目远程就能做:我告诉你怎么拍样本、录视频,你发过来就行。需要现场调光源、装相机的,同城可以上门,外地另算差旅。
- 相机、光源、工控机要我自己买吗?
- 可以先用你现有的设备试。要新买的话,我按你的预算列清单、帮你选型,你自己采购。
- 一般多久能做完?
- 看样本 1–3 天;常见的检测项目,首版 1–2 周。最后取决于样本质量和验收标准有多严。
- 能开发票吗?
- 需要发票的话看样本时就提出来,我们一起定开票方式,比如通过接单平台走账。